Ter backup é só metade do caminho: devolve dados, mas não garante que o serviço volta a tempo nem que alguém sabe executar o restauro sob pressão. O site já cobriu o 3-2-1 e o backup imutável contra ransomware e o plano de resposta. O que normalmente falta é o plano em papel: quanto tempo o negócio aguenta sem cada sistema, quanto dado aceita perder, e que passos concretos devolvem o sistema ao ar. É isso que um plano de recuperação de desastre (DR) formaliza, com duas métricas que não podem ficar vagas: RPO e RTO.
Neste artigo
- 1. RPO e RTO: duas respostas que não são a mesma
- 2. A BIA: saber o que importa antes de saber guardar
- 3. Estratégias que fazem cumprir os objectivos
- 4. O runbook do restauro
- 5. Testar é obrigatório
- 6. Azure Site Recovery no cenário PME
- 7. Erros comuns
- 8. Checklist
- Artigos Relacionados
- Fontes Oficiais
1. RPO e RTO: duas respostas que não são a mesma
- RPO (Recovery Point Objective) — o máximo de dados que o negócio aceita perder, medido em tempo até ao último ponto recuperável. Um RPO de 1 hora significa: depois do desastre, o backup mais recente pode estar no máximo uma hora atrás do momento da quebra.
- RTO (Recovery Time Objective) — o máximo de tempo que o negócio aceita ficar sem o serviço antes de a paragem se tornar inaceitável. Um RTO de 4 horas significa: quatro horas depois do incidente, o sistema tem de estar a servir.
O RPO é uma pergunta de dados (o que se perdeu), o RTO é uma pergunta de tempo e processo (quanto leva a estar de pé). Um backup semanal cumpre um RPO de 7 dias — nunca um RPO de 1 hora. Os dois valores definem-se por serviço, não para a empresa inteira — e a conversa é com o dono do negócio, não só com a TI. Um exemplo de tabela para PME, que é o resultado esperado desta fase:
| Serviço | RPO | RTO | Necessita |
| ERP/facturação | 1h | 4h | Réplica contínua + restauro testado |
| Servidor de ficheiros | 24h | 1 dia | Backup diário + cópia na cloud |
| Email (Microsoft 365) | — (SLA) | SLA | Plano da Microsoft + backup de terceiros |
| AD/DC | 0h (redundância) | ≤2h | Segundo DC + restauro de floresta testado |
⚠️ Atenção
Um RPO ou um RTO escritos sem as pessoas do negócio é um documento de TI que ninguém validou. As perguntas de custo (quanto custa ficar sem facturação uma tarde?) são de gestão, e a resposta determina o preço da solução técnica.
Em SaaS como o Microsoft 365 não existe um RPO ou um RTO contratado por cliente: a Microsoft publica SLAs de disponibilidade do serviço, e a recuperação de dados apagados depende da retenção e do backup de terceiros.
2. A BIA: saber o que importa antes de saber guardar
O NIST, no guia de referência para planos de continuidade (SP 800-34), organiza o trabalho numa sequência: primeiro a BIA (Business Impact Analysis) — identificar os processos de negócio, o que os suporta tecnicamente, o impacto de os perder e quando passa a ser inaceitável. Depois as medidas preventivas, a escolha de estratégias de continuidade, o plano, os testes e a manutenção. Numa PME, a BIA cabe numa tarde: liste os 10-15 serviços críticos (email, ERP, ficheiros, AD, telefonia, site), o custo de ficar sem cada um por hora e quem depende dele.
O resultado é a tabela com RPO e RTO por serviço e uma ordem de recuperação: há serviços de que os outros dependem (AD, rede, VPN) e que têm de voltar primeiro, mesmo que o impacto directo de negócio pareça menor.
3. Estratégias que fazem cumprir os objectivos
Cada RPO exige um mecanismo de captura com frequência igual ou melhor. As opções, por ordem crescente de investimento:
- Backup tradicional — diário ou horário, no 3-2-1 que o site já detalhou. Cumpre RPOs de horas a dias, e o RTO depende da velocidade de restauro e do tamanho do conjunto de dados.
- Réplicas locais — VMs replicadas (Hyper-V Replica, vSphere Replication) entre hosts. RPOs de minutos, RTOs de minutos quando a infra-estrutura não caiu toda.
- Replicação para a cloud (Azure Site Recovery, na secção 6) — RPO de minutos, sobrevive à perda do site completo.
- SaaS com redundância própria — Microsoft 365, Google Workspace e afins cumprem os seus próprios SLAs de disponibilidade. O que falta é retenção de dados própria (o que o cliente apaga desaparece nos dois lados da cloud).
O RTO é cumprido pelo procedimento, não pelo produto: hardware pronto a receber, software de restauro, documentação, pessoas que sabem executar. Daí o runbook.
4. O runbook do restauro
O runbook é o documento que outra pessoa — não só quem o escreveu — consegue executar às 3h da manhã. Para cada serviço crítico:
- Passos concretos do restauro (comandos, onde estão os backups, quanto tempo costuma demorar).
- Ordem de recuperação — AD e infra-estrutura de rede primeiro, depois os serviços de negócio, pela ordem da BIA.
- Responsáveis e suplentes por passo, números de contacto (fornecedores de hardware, ISVs, suporte Azure).
- Critérios de activação — quem declara o desastre, e quem substitui essa pessoa se estiver de férias.
- Como comunicar a interrupção a utilizadores e clientes, com modelos de mensagem escritos com antecedência.
Imprima, guarde em papel e numa cloud separada da infra-estrutura que pode estar a arder — um runbook guardado apenas no próprio servidor morre com o servidor.
5. Testar é obrigatório
Um plano nunca testado é uma hipótese. Os testes, por ordem de esforço:
- Tabletop — sentar a equipa, percorrer o cenário, apanhar buracos no runbook. Duas horas, uma vez por semestre.
- Restauro parcial — restaurar um ficheiro, uma VM, uma mailbox: medir quanto demora de verdade e comparar com o RTO prometido.
- Failover completo — uma vez por ano, para o serviço mais crítico: subir a carga no ambiente alternativo, validar a aplicação e voltar para trás.
Documente cada teste: o que correu, o que falhou, o que mudou no plano. O histórico de testes é a prova que um auditor, um segurador ou o cliente pede depois das coisas correrem mal.
6. Azure Site Recovery no cenário PME
Para as VMs mais críticas (o ERP, o servidor que ninguém pode perder), o Azure Site Recovery (ASR) é o serviço da Microsoft para DR: replicação contínua das VMs para o Azure, failover para lá quando o desastre acontece e failback para o local quando o local recupera. Os cenários suportados: VMs VMware, VMs Hyper-V e servidores físicos Windows/Linux replicando para o Azure, além de VMs Azure entre regiões. O ASR mede o RPO de cada VM e permite configurar alertas quando o limite definido é ultrapassado. A opção High Churn, para VMs Azure replicadas entre regiões Azure (Azure-to-Azure) e não para VMs locais, suporta escritas até 500 MB/s nas configurações suportadas.
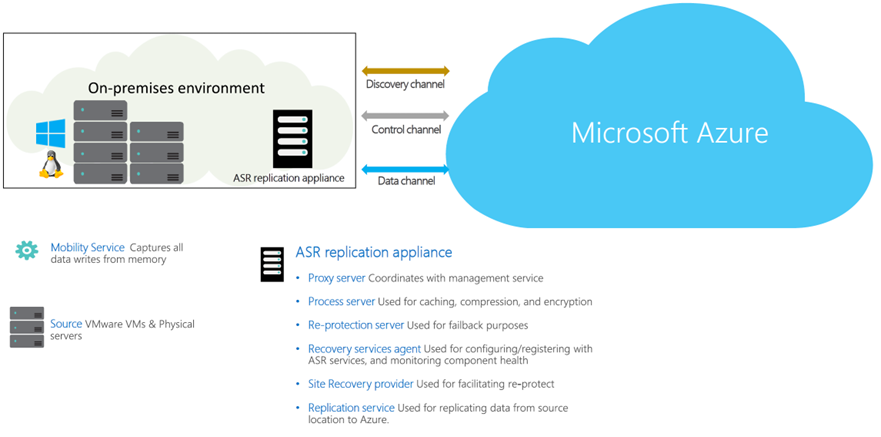
Replicação contínua do local para o Azure via appliance ASR — diagrama oficial Microsoft Learn
Tecnicamente: cada VM tem o Mobility Service, que captura as escritas, e o appliance de replicação concentra a cache, a compressão e a encriptação. A comunicação com o Azure faz-se por três canais (deteção, controlo, dados). O test failover sobe as VMs replicadas numa rede isolada no Azure sem tocar no ambiente de produção — é a forma mais simples de provar que o RTO é cumprível sem interromper ninguém.
ASR não substitui o backup
O Azure Backup e o Azure Site Recovery fazem coisas diferentes: o Backup guarda versões do dado ao longo do tempo (o RPO de dias e a recuperação de ficheiros), e o Site Recovery mantém um sistema replicado para ligar noutro sítio (a continuidade do serviço). Um plano de PME completo usa os dois: backup para o dado, ASR para o serviço crítico. Note-se que uma encriptação por ransomware no local não se recupera pelo ASR sozinho — o que se cifra no destino replica-se cifrado. É para isso que existe a cópia imutável.
O custo na PME: o ASR cobra por instância protegida, soma o armazenamento de réplicas e a cache na conta de armazenamento durante a replicação, e o Azure consumido no failover. Os valores actuais estão na página de preços do Azure Site Recovery. Para a maioria das PMEs, proteger 2-5 VMs críticas em DR e manter o resto só com backup é o ponto de equilíbrio razoável — a BIA decide quais.
7. Erros comuns
- RPO e RTO globais («um dia para tudo») em vez de por serviço — o custo explode ou a promessa não se cumpre.
- Backups guardados na mesma infra-estrutura dos dados (o ransomware cifra os dois).
- Nunca ter feito um restauro de verdade — o backup funciona, o restauro não.
- Runbook dependente de uma única pessoa e da memória dela.
- Password do admin de backup partilhada por email — as credenciais de acesso à cópia de backup são contas Tier 0, com restrições de logon e estações dedicadas.
8. Checklist
- [ ] BIA feita com o negócio, não só pela TI
- [ ] Tabela RPO/RTO por serviço, validada pela gestão
- [ ] Backup 3-2-1 com uma cópia imutável
- [ ] Runbook por serviço crítico, em papel e fora da infra-estrutura
- [ ] Testes periódicos agendados (tabletop + restauro parcial + failover anual)
- [ ] ASR activo nas VMs que a BIA marcou como críticas
- [ ] Contactos de emergência e critérios de declaração de desastre escritos
Veredicto
Um backup sem plano é uma lotaria: às vezes devolve os dados, raramente devolve o serviço a tempo. O trabalho de DR é, primeiro, conversa com o negócio para fixar RPO e RTO por serviço, depois mecanismos à altura dessas promessas, um runbook que outra pessoa consegue executar, e testes que provam tudo isto por escrito. O Azure Site Recovery entra onde a BIA marcou serviço que não pode parar — e nunca substitui o backup imutável que o ransomware não cifra.
Artigos Relacionados
- Ransomware 2026: Como Preparar, Detectar e Recuperar (Backup Imutável 3-2-1)
- Plano de Resposta a Ransomware: Guia para Empresas Portuguesas